Gemini 4 Argonとは、Google DeepMindが2026年9月30日(米国時間)に発表した第4世代最初のフロンティアAIモデルで、1回の応答で最大約100万(1,048,576)トークンを出力できる1。Gemini 3世代の出力上限(65,536トークン)の16倍にあたり、数時間から数日かかる多段階の業務を1回の推論で最後まで進める自律型エージェントの用途を主眼に設計された1。サイバー防衛の専門家向けの先行提供を経て、2026年10月13日(米国時間)に開発者向けAPI、企業向け基盤、Google AI Pro/Ultraで一般提供が始まった6。
本稿は、日本時間で一般提供が始まった2026年10月14日時点で、Googleの公式ブログとモデルカード、報道記事、第三者の評価サイトなど(引用文献一覧43件)をもとに、仕様、ベンチマーク、Google Antigravityでの活用事例、安全対策、料金体系と導入時の注意点を整理した調査資料である。掲載した仕様・料金・ベンチマークは提供元や各記事が公表した値であり、筆者が実測したものではない。
1. Gemini 4 Argonとは:エグゼクティブ・サマリーと世代交代の戦略的文脈
2026年9月30日(米国時間、日本時間10月1日)、Google DeepMindのシニアバイスプレジデント兼GoogleチーフAIアーキテクトであるKoray Kavukcuoglu氏より、第4世代の幕開けを告げる初のフロンティアAIモデル「Gemini 4 Argon」(APIモデルID:gemini-4-argon)が発表された1。発表当初、同モデルは高度なサイバーセキュリティ能力に伴う悪用リスクを管理するため、米国政府の自主的事前アクセスプロセスに参画しつつ、審査されたサイバー防衛専門家向けの「Fairwind Program」およびGoogle社内チームに限定して先行提供されていた2。その後、セーフガードの検証を経て、2026年10月13日(米国時間、日本時間10月14日)より、開発者向けAPI、エンタープライズ基盤、および一般消費者向け有料プラン(Google AI Pro / Ultra)を対象としたグローバルでの一般提供(GA:General Availability)が一斉に開始されている6。
Gemini 4 Argonの登場は、単なるモデルのバージョンアップにとどまらず、GoogleのAI開発戦略における3つの構造的転換を象徴している。第一に、モデルの設計思想が従来の「質問に対する高速・高精度な応答」から、「数時間から数日におよぶ複雑かつ多段階の業務ワークフローを単一の推論プロセスで最後まで完遂する」という長期推論(Long-horizon reasoning)および自律型エージェント(Agentic AI)へと完全に移行した点である1。これまでGeminiシリーズは膨大な資料を読み込む「入力コンテキストの広さ」を強みとしてきたが、Argonでは1回の応答における最大出力上限を従来の約6万4,000(65,536)トークンから約15.6倍となる100万(1,048,576)トークンへと劇的に拡張した1。これにより、調査、仮説立案、コード改修、テスト実行、エラー解析、再修正という反復的なエージェントループを文脈の分断なしに単一の推論軌跡(トラジェクトリ)内で完結させることが可能となった2。
第二に、モデルラインナップの命名規則と開発パイプラインの再編である。Googleはこれまで「Ultra」「Pro」「Flash」「Nano」といったティア表記でモデルの規模と用途を分類してきたが、Gemini 4世代では周期表の希ガス元素に由来する「Argon(アルゴン)」という名称を初めて冠した1。Googleのモデル開発動向を振り返ると、2025年11月の「Gemini 3 Pro」、2026年2月の「Gemini 3.1 Pro」に続き、2026年6月に予告されていた「Gemini 3.5 Pro」が同年8月にキャンセルされ、7月の「Gemini 3.6 Flash」および9月2日の「Gemini 3.8 Flash」を経て、開発リソースがGemini 4世代の事前学習と強化学習へ集中投下された経緯がある7。さらに内部開発においては「Argon」「Barium」「Carbon」といったアルファベット順の元素コードネームを用いた複数のチェックポイント開発が並行して走っており、社内評価にかけられた「Barium」系列のうち「Barium-B」が公開版の「Argon」として選出された一方、さらなるコーディング性能向上を目指した「Carbon」の内部テストや軽量版である「Gemini 4 Flash」の展開準備も進められていることが判明している12。
第三に、モデルの能力評価軸が抽象的な学術パズルから「実体経済への直接的貢献度」へとシフトした点である。約4週間前の2026年9月初旬にOpenAIが投入したフラッグシップモデル「GPT-6 Astra」や、Anthropicの「Claude Opus 5.5」「Claude Fable 5.1」との競争において、Argonは米国GDPへのセクター別貢献度で重み付けされた経済影響度指標「Vals Index」で首位を獲得し、特に法務・財務・ビジネス自動化・長期ソフトウェア工学・サイバー防衛において競合を大きく引き離す性能を実証している2。
| 比較項目 | Gemini 3世代(3.1 Pro / 3.8 Flash) | Gemini 4 Argon(gemini-4-argon) | 世代間シフトの戦略的意義 |
|---|---|---|---|
| 発表日 / 一般提供日 | 2026年2月(3.1 Pro)/ 2026年9月(3.8 Flash) | 2026年9月30日発表 / 2026年10月13日一般提供開始 | 2週間のサイバー防衛先行提供(Fairwind)を経た段階的GA7 |
| アーキテクチャ基盤 | 既存世代のマルチモーダル基盤 | 新規構築のスパースMoEトランスフォーマー | 既存モデルの改修ではなくゼロから再設計された新世代基盤16 |
| コンテキストウィンドウ | 入力中心の大容量コンテキスト | 1,048,576トークン(入出力統一コンテキスト) | 入力と出力で100万トークンのプールを共有・動的配分8 |
| 最大出力トークン上限 | 65,536トークン(約6.4万) | 1,048,576トークン(Long Decode時 / 同期デフォルト65,536) | 約15.6倍の出力枠拡大により数十万トークンの連続推論を実現5 |
| 入力・出力モダリティ | マルチモーダル入出力(バリアントによる) | 入力:テキスト・画像・動画・音声・PDF / 出力:テキスト | 視覚・音声・長尺動画の深い理解と長大なテキスト・コード生成に特化9 |
| 設計思想と主戦場 | 高速応答・汎用推論・コスト効率処理 | 長時間・多段階の自律エージェント遂行・深い推論維持 | 質疑応答ツールから「業務を完遂する自律労働力」への転換1 |
| 知識カットオフ | 2025年〜2026年初頭 | 2026年3月 | 最新の技術・法制・セキュリティ動向を反映16 |
2. アーキテクチャ仕様と「最大100万出力トークン」の技術的本質
スパースMoE基盤と学習・推論インフラストラクチャ
公式モデルカード(Model Card)の仕様によれば、Gemini 4 Argonは大規模なスパースMixture-of-Experts(MoE)トランスフォーマーアーキテクチャを採用しており、過去のモデルのファインチューニングや部分改修ではなく、完全に新規のフロンティアモデルとして設計・学習されている16。学習インフラにはGoogle独自のカスタムASICであるTPU(Tensor Processing Units)および大規模クラスターであるTPU Podが全面的に採用され、ソフトウェアフレームワークとして「JAX」および「ML Pathways」を用いることで、広帯域かつ電力効率の高い分散学習が実行された16。
事前学習(Pre-training)データセットは、Webドキュメント、コード、画像、音声(発話および非発話)、動画を網羅する大規模なマルチモーダルコレクションで構成されている16。データソースには公開データセット、Webクローラー収集データ(robots.txtを遵守)、商用ライセンスデータ、プライバシーポリシーとユーザー管理下で許諾されたGoogle製品・サービスのデータ、内部生成データ、および合成データ(Synthetic Data)が含まれ、GoogleのAI原則に沿った厳格な重複排除・品質フィルタリング・安全性フィルタリングおよび有害コンテンツの除去が施されている16。さらに事後学習(Post-training)においては、指示チューニング(Instruction tuning)と人間の選好データ(Human-preference data)に加え、多段階の推論、問題解決、および定理証明(Theorem-proving)データを活用した大規模な強化学習(Reinforcement Learning)が適用されており、これが長期タスクにおける論理の一貫性を支える中核となっている16。
「Long Decode(100万出力トークン)」が解決する推論ボトルネック
Gemini 4 Argonの技術仕様において最も注目すべきは、入出力合計で1,048,576トークンの統一コンテキストウィンドウ(Unified Context Window)を備えつつ、Long Decode機能を有効化することで単一レスポンスあたり最大1,048,576トークン(約100万トークン)の出力を可能にした点である9。
この「出力100万トークン」という仕様の本質的な価値は、単に長大なドキュメントを一括出力することにあるのではない5。現代の推論特化型モデル(Reasoning Models)においては、最終的な回答を出力する前段階の「内部思考連鎖(Chain-of-Thought)」や、自律エージェントが外部ツールを呼び出して試行錯誤する中間ステップの生成すべてが「出力トークン」として消費される5。従来の64K(65,536)トークンという出力上限下では、数万〜数十万行のコードベース改修や複雑な財務・法務調査を行う際、モデルが十分な思考と検証を行う前に出力上限に達して処理が強制終了していた1。その結果、人間または外部オーケストレーターが「続きを実行せよ」と再度プロンプトを投げ直す必要が生じ、そのつど前半の微細な推論コンテキストが失われ、作業方針のブレ(Logic Drift:論理ドリフト)やハルシネーションが誘発されていたのである1。
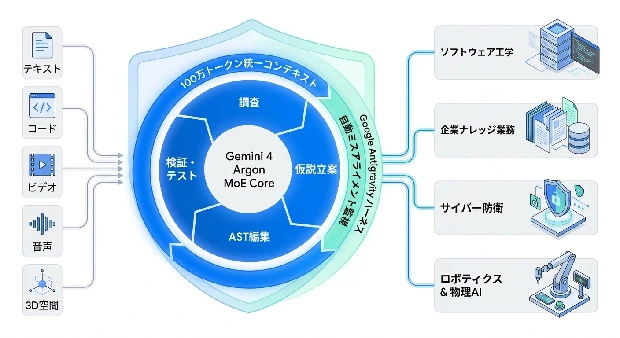
出力上限が100万トークンに引き上げられたことで、Argonは1つの連続した推論トラジェクトリの中で数十万トークンにおよぶ思考とアクションを展開する「思考の余白」を獲得した2。特にソフトウェアエンジニアリング領域では、モデル内部でコードの抽象構文木(AST:Abstract Syntax Tree)を意識しながら、複数ラウンドの編集にわたって一貫した仮説(Consistent Hypothesis)を維持するよう設計されている19。これにより、表面的なシンタックスエラーの修正にとどまらず、ビルド失敗やパフォーマンス劣化の真の根本原因(Root-cause)を突き止めて自己修正する極めて高いレジリエンスが実現されている19。
3. ベンチマーク徹底解剖:競合フロンティアモデルとの多角的比較
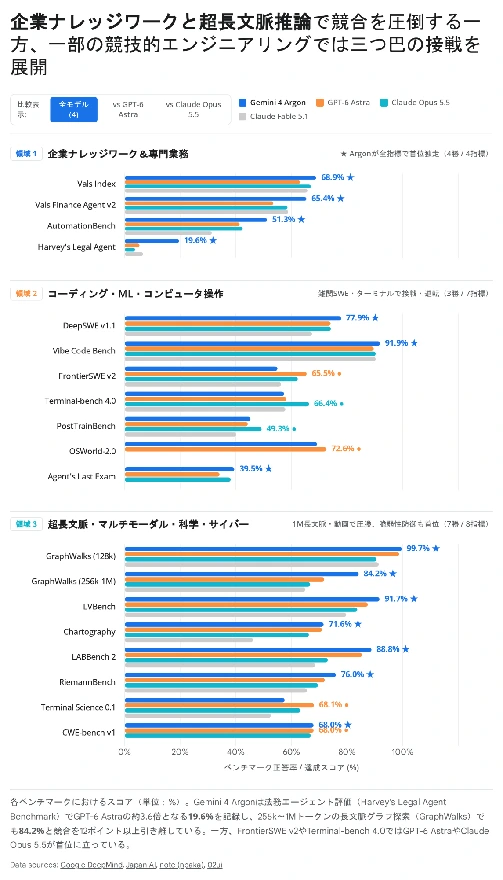
Googleが公表した19の主要業界ベンチマークにおいて、Gemini 4 Argonは13項目で単独首位、1項目(CWE-bench v1)でOpenAIの「GPT-6 Astra」と首位タイとなり、計14項目でトップの座を獲得した1。一方で残りの5項目では「GPT-6 Astra」またはAnthropicの「Claude Opus 5.5」が優位に立っている15。以下の視覚化は、公式モデルカードおよび第三者評価に基づく主要4モデルの領域別性能プロファイルを示している。
企業ナレッジワークと超長文脈における圧倒的優位性
ベンチマーク結果を詳細に分析すると、Gemini 4 Argonの最大の強みは「実世界のホワイトカラー専門業務(法務・財務・税務・業務自動化)」と「超長文脈・マルチモーダル情報の統合処理」が交差する領域にあることが明確に浮かび上がる15。
米国経済分析局(BEA)のデータに基づき、金融、コーディング、法務、税務の各セクターが米国GDPに占める割合でモデル性能を重み付け評価する「Vals Index」において、Argonは68.9%を記録し、Claude Opus 5.5(67.0%)、Claude Fable 5.1(65.8%)、GPT-6 Astra(63.1%)を抑えて総合1位に立った16。小さなニッチ領域で高得点を取るよりも経済規模の大きい基幹産業で高い遂行力を持つモデルが高く評価されるこの指標で首位に立った事実は、エンタープライズ導入における直接的な投資対効果を示唆している17。
とりわけ劇的な差がついたのが法務領域である。複雑な判例調査や規制当局への提出書類のレビュー、契約書ドラフティングの精度を測る「Harvey's Legal Agent Benchmark」において、Argonは19.6%を達成した5。これはGPT-6 Astra(5.4%)の約3.6倍、Claude Fable 5.1(6.7%)の約2.9倍、Claude Opus 5.5(3.8%)の実に約5.1倍にあたるスコアであり、他のフロンティアモデルがほとんど歯が立たない高難度の法務エージェントタスクにおいて独走状態にある16。法務AIプラットフォームを提供するHarvey社の応用研究責任者Niko Grupen氏も、企業M&A、データプライバシー・サイバーセキュリティ、ベンチャーキャピタル法務のすべてにおいてGemini 3.1 Proから飛躍的な向上を確認したと証言している3。また、多段階の財務リサーチを評価する「Vals Finance Agent v2」でも65.4%(Astra比+11.9ポイント)、Zapierによるエンドツーエンドの業務自動化指標「AutomationBench」でも51.3%(Astra比+9.9ポイント)と、およそ10〜14ポイントの圧倒的なリードを築いている2。さらに、ServiceNowと共同開発したエンタープライズ業務評価「NowAI-Bench」の早期アクセス検証でも、Gemini 3.8 Flashと比較してタスク成功率が約20%向上し、特に人事(HR)およびカスタマーサービス領域で顕著な成果を上げている3。
この専門業務での強さを根底で支えているのが、超長文脈における情報保持能力である。コンテキスト内のグラフ構造を幅優先探索(BFS)で辿る「GraphWalks」ベンチマークにおいて、128kトークンまでの領域ではArgon(99.7%)とAstra(98.7%)はともに99%前後の高いF1スコアを示す16。しかし、コンテキスト長が256kから100万(1M)トークンに拡大すると、GPT-6 Astraが71.8%、Claude Opus 5.5が66.8%、Claude Fable 5.1が65.0%へと急激に精度を落とすのに対し、Argonは84.2%という極めて高い推論一貫性を維持している16。これに加え、長尺動画理解の「LVBench」で91.7%(Astra 87.5%)、複雑なチャート解析の「Chartography」で71.6%(Astra 71.0%)を記録しており、テキスト・表・画像・長時間動画が混在する非構造化データを一括で処理し、引用の忠実性(Citation fidelity)を保ちながら統合されたアウトプットを生成する能力において業界最高峰に位置している2。
コーディング・科学領域での勝敗分岐と「最強モデル」神話の解体
一方で、コーディングや科学・ターミナル操作のベンチマークを精査すると、Argonが決して「すべての指標で無敵のモデル」ではないという客観的事実が見えてくる1。
ソフトウェアエンジニアリング領域では、評価タスクの性質によって明確に勝敗が分かれている。既存の大規模コードベースを読み解き、長期にわたって変更・テスト・修正を繰り返す実世界志向の「DeepSWE v1.1」ではArgonが77.9%で首位(Opus 5.5が74.2%、Astraが74.1%)に立ち、実際に動作するアプリケーションの構築能力を測る「Vibe Code Bench」でも91.9%(Opus 5.5が90.3%、Astraが89.6%)でトップを獲得した5。しかし、極めて難解な単発・最先端のソフトウェア工学課題を測る「FrontierSWE v2」では、GPT-6 Astraが65.5%、Claude Opus 5.5が62.3%を記録したのに対し、Argonは55.0%と10.5ポイントの差をつけられて敗北している15。また、コマンドライン環境の操作能力を測る「Terminal-bench 4.0」ではClaude Opus 5.5が66.4%と突出しており、Argon(57.4%)はGPT-6 Astra(58.2%)やClaude Fable 5.1(57.9%)の後塵を拝している15。機械学習の事後学習エンジニアリングを評価する「PostTrainBench」でもClaude Opus 5.5(49.3%)が首位であり、Argonは45.3%にとどまる16。
科学・数学およびコンピュータ操作(Computer Use)でも同様の分岐が見られる。生物学研究の「LABBench 2」(88.8%)や高度な数学の「RiemannBench」(76.0%)、エージェント総合試験「Agent's Last Exam」(39.5%)ではArgonが首位を獲得した一方、科学系のターミナル作業「Terminal-Bench Science 0.1」ではGPT-6 Astra(68.1%)がArgon(57.6%)を10.5ポイント引き離し、OS操作の「OSWorld-2.0」でもAstra(72.6%)がArgon(69.2%)を上回っている15。
独立した第三者評価機関による総合スコアも、この拮抗状態を如実に反映している。Artificial Analysisの総合知能指標(Intelligence Index)では、Gemini 4 Argon(高推論モード)とGPT-6 Astraはともに53点で同率首位に並んでおり(低推論モードのGPT-6 Astra lowは46点)、Respan社の総合指標「Respan Index」ではGPT-6 Astraが70.5点(総合2位)、Gemini 4 Argonが70.3点(総合3位)とわずか0.2ポイント差のデッドヒートを演じている1。Respanのカテゴリ別内訳を見ると、Argonは「Agents(77.0 vs 75.9)」「Knowledge & language(75.8 vs 71.2)」「Human preference(59.7 vs 57.4)」でAstraを上回る一方、「Coding(61.8 vs 64.4)」や「Reasoning(77.1 vs 78.0)」の純粋な正答率ではAstraが一歩リードしている1。
| 第三者評価機関 / 指標カテゴリ | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | 分析的示唆・特徴 |
|---|---|---|---|---|
| Artificial Analysis Intelligence Index | 53点(高推論) | 53点(標準)/ 46点(Low) | — | 総合的な知能到達度ではArgonとAstraが完全に同率首位で拮抗1 |
| Respan Index(総合スコア) | 70.3点(全体3位) | 70.5点(全体2位) | — | 共通8指標のうち5指標でAstraがリードするも総合差はわずか0.2点24 |
| Respan:Agents(エージェント遂行) | 77.0点 | 75.9点 | — | 多段階の自律ワークフロー継続力でArgonが優位24 |
| Respan:Knowledge & Language | 75.8点 | 71.2点 | — | 専門知識の正確性とハルシネーションの低さでArgonが大きくリード1 |
| Respan:Human Preference | 59.7点 | 57.4点 | — | 曖昧な言い回し(Hedging)や決まり文句を排した文体で人間評価が高い8 |
| Respan:Coding / Reasoning | 61.8点 / 77.1点 | 64.4点 / 78.0点 | — | 単発の高難度アルゴリズム・純粋推論正答率ではAstraが優位1 |
| ERQA(ロボティクス空間・物理推論) | 87.0% | 下回る(非公表) | 下回る(非公表) | 3D空間認識と物理的相互作用の純粋推論で全フロンティアモデル中1位26 |
すなわち、極限のアルゴリズム的難問やターミナル上での単発競技ではGPT-6 AstraやClaude Opus 5.5が依然として強力な選択肢である一方、数百万行のレガシーコード移行や数百ページの契約書・財務元帳の突き合わせといった「文脈維持と幻覚抑制が求められる長時間の実務統合ワークフロー」においては、Gemini 4 Argonが明確な優位性を持っていると結論づけられる1。
4. エージェント開発基盤「Google Antigravity」との融合と実世界での導入インパクト
Gemini 4 Argonの真価は、単体のチャットボットとしてではなく、Googleが展開するエージェント主導型(Agent-first)開発・業務プラットフォーム「Google Antigravity」および「Agent Development Kit(ADK)」「AlphaEvolve」と統合された際に最も強く発揮される3。
Google Antigravityの4サーフェス構造と社内導入の定量成果
2025年11月にGemini 3と同時にパブリックプレビューとして登場した「Google Antigravity」は、当初のAI搭載IDE(VS Codeフォーク)から、2026年現在ではエージェント主導のソフトウェア開発・知識業務を統括する包括的なエコシステムへと進化を遂げている27。現在、Antigravityは同一の基盤エージェントハーネス(Antigravity Harness)上で動作する4つのサーフェスで構成されており、ユーザーの役割や作業形態に応じた柔軟なオーケストレーションを可能にしている30。その中核となるスタンドアロン・デスクトップアプリ「Antigravity 2.0」は、IDEから独立して動作するコマンドセンターとして機能し、複数のプロジェクトにまたがるローカルおよびバックグラウンドの自律エージェントを非同期・並列に起動・監視するほか、定期的なコード品質チェックや古いパッケージの検出といったスケジュール実行を統合管理する30。ターミナル操作やヘッドレス実行を好むエンジニア向けには、高速性を追求してGo言語で再構築された「Antigravity CLI」が提供されており、アクティブなコマンドラインをロックすることなくSSH経由のリモート作業やコンテナ内でのバックグラウンドエージェント起動を実現している28。一方、エージェントが生成した計画や根拠(Artifacts)を確認しながらコード変更を1行ずつレビュー・承認したい開発者向けには、専用エディタ(v2.5.5)および既存IDE向け公式拡張機能(VS Code、Visual Studio 2026、JetBrains製IDE群、Zed、Xcode、Android Studio Canaryに対応)を備えた「Antigravity IDE」が用意されている19。さらに、カスタムエージェントロジックや自動化パイプラインをゼロから構築したいチーム向けにはPythonライブラリの「Antigravity SDK」が提供されており、ローカルで記述したエージェントをコード変更なしでGoogle Cloudへそのままデプロイできる環境が整えられている30。
特筆すべきアーキテクチャ上の工夫は、Markdownファイル1つ(YAMLフロントマターによる使用可能ツール・スキルの制限と、本文のシステムプロンプト化)で定義できる「カスタムエージェント」と、「Skills(スキル)」によるプログレッシブ・ディスクロージャー(段階的開示)の仕組みである31。プロジェクト固有のルールや全ツールを最初からコンテキストウィンドウに詰め込むと、トークン肥大化(Tool bloat)によるコスト増やレイテンシ悪化、モデルの混乱を招くが、Antigravityでは.agents/skillsやMCP(Model Context Protocol)サーバーを通じて必要なスキルのみを動的に読み込ませることで、Argonの推論精度と経済性を両立させている20。
Alphabet社内ではすでに月間10万人以上(100,000+ MAU)の従業員が内部版Antigravity上でArgonを活用している20。その結果、直近4週間でソフトウェアエンジニアによるエージェント経由のコード提出(サブミッション)数が35%以上増加したと同時に、本番環境への提出後のコードロールバック(不具合等による差し戻し)が約30%(約3分の1)減少するという、開発ベロシティとコード品質の双方を劇的に改善する成果が記録された8。さらに利用層はコアエンジニアリング部門にとどまらず、Google Cloud営業部門の50%以上、財務チームの約50%、ビジネス・オペレーション人員の33%以上へと急速に浸透している20。
大規模エンジニアリング・科学計算・企業業務における象徴的実績
Google社内外の実際のプロダクション環境において、Gemini 4 Argonは従来のモデルでは不可能だった規模のタスクを次々と完遂している。
| 領域・プロジェクト | 対象システム・規模 | Gemini 4 Argonが遂行したタスク内容 | 定量的・定性的インパクト |
|---|---|---|---|
| 大規模リファクタリング | Chromium(全体約4,000万行 / 対象レガシー部約600万行) | 約600万行のレガシーフォルダからWebページ処理の中核を切り離す数百ファイル横断のアーキテクチャ改修7 | 数カ月を要する作業を数週間で完了。リロードなしのタブ・ウィンドウ間移動を実現しクラッシュ要因を根絶8 |
| メモリ安全言語への移行と最適化 | Fuchsia Zircon kernel(80万行超)、re2、libgav1、科学用Fortranコード | C/C++およびFortranコードベースのRustへの自律移行。libgav1では3.2万行のSIMDコードを置換しコンパイラ自動ベクトル化を誘導2 | 動画デコーダlibgav1で既存Rust版比2.7倍の高速化(最適化C++に迫る性能)。Fortran移行では1.8倍高速化220 |
| データセンター基盤の自律最適化 | Googleグローバルデータセンター群 | 複数のArgonエージェントがフリート全体のプロファイリングテレメトリを自律解析しメモリ最適化を適用2 | 展開後に300TiB以上のメモリを解放。最終的に500TiB〜1PiBのメモリ節約を見込む2 |
| フロントエンド性能改善 | YouTubeコメント・フロントエンド | 本番プロファイルデータを追跡し、絵文字の冗長レンダリングがサーバー負荷の約45%を占めるボトルネックを特定・12箇所を最適化20 | CPUフットプリントを半減(50%削減)、サーバー読込遅延を30ms、クライアントE2E遅延を20ms短縮20 |
| AI推論・フレームワーク高速化 | Gemma 4(E2B / NVIDIA A100上vLLM)およびGoogle ADK | vLLM上の推論パイプライン最適化、およびADK(Python)の.agents/skillsに基づく夜間自律改修8 | Gemma 4推論を品質劣化ゼロで2.85倍高速化(37,900→108,000+ tok/s)。ADKの長期セッション準備時間を40%短縮8 |
| 量子計算・量子化学・物理シミュレータ | 量子アルゴリズム、オープンソース量子化学xTB、Wingドローン物理シミュレータ | 量子ビット×ゲートの時空間リソース最適化、xTBコード最適化、航空力学・推進力・構造力学の数理デバッグ2 | 量子計算で公表基準値を数分で40%上回る。xTB構造予測を最大2.3倍高速化。ドローン物理モデルに18の改善案を提示2 |
| IT運用・バグトリアージ・障害復旧 | 複数サービスの未解決バグ134件 / データセンターP0障害 | コミット履歴と本番テレメトリを照合したバグ精査。非エンジニア(TPM)による3,200行のDBパイプライン全面改修20 | 3時間未満で重複・解決済み97件を証拠付きでクローズ(72.4%削減)。4カ月停滞していたP0障害を数日で解決20 |
| 財務(FP&A)・営業・ローカライズ | 全社財務80ワークフロー / 広告営業 / 開発者ドキュメント | 元帳照合・予算追跡・契約抽出、Webトラフィックと社内DBを照合した見込み客精査、17言語へのドキュメント一括翻訳20 | 15.5時間の人間指示から約335時間分(8週間超相当)の財務成果物を生成。営業調査時間を90%削減20 |
フィジカルAI・ロボティクス開発ライフサイクルの刷新
さらに2026年10月13日には、ロボティクス領域におけるArgonの活用成果も公開された26。3D空間における物理的・空間的問題解決能力を測る「ERQA(Embodied Reasoning)」ベンチマークで純粋推論により87%という最高スコアを叩き出したArgonは、マルチビュー映像、3D空間幾何学、接触力学(Contact mechanics)、およびロボットの固有受容感覚(プロプリオセプション)テレメトリを単一モデル内でネイティブに統合推論する26。
この統合された物理マルチモーダル推論能力は、ロボティクスの開発ライフサイクル全体を4つの側面から刷新している26。第一の「ロボット制御(Real-to-Sim-to-Realおよびゼロショット制御)」においては、Boston Dynamicsの四足歩行ロボット「Spot」(12自由度脚+6自由度アーム)を操作する際、Argonはまずペダル式ゴミ箱の関節付きMuJoCoデジタルツインを自律生成してバランスと動作をシミュレーション内で練習し、その上で2つの検証エージェント群(foot-verifierとhand-verifier)を用いて前足のペダル中央配置と3D空間での手とゴミ箱のアライメントを確認してから空き缶を投棄する一連の制御を完遂した26。また、手首カメラに2cm単位のワールド座標グリッドを重ねた視覚ハーネスを用いたゼロショット物体操作(倒れたマグカップを起こして丸めたナプキンを入れる等)や、「Gemini Omni World Model」内での中間キーフレーム評価を通じた双腕制御(スクラブルのタイルを並べてA-R-G-O-Nと綴る際に視界を遮らないよう非稼働側の手を自動で引っ込める動作など)も実現している26。
第二の「Real2Sim(実世界からシミュレーション環境の自動再構築)」では、ロボットの遠隔操作映像や人間の一人称作業映像、さらには紙の手描きスケッチから、GPUアクセラレーション対応のmujoco_warpや500HzのMuJoCo接触物理環境(76自由度の双腕ヒューマノイド・22自由度の五指ハンド)上の3Dデジタルツインを自動構築する26。ボウルやトレイのような凹面形状の物体を単純なバウンディングボックスではなく複合凸分解(Compound convex-decomposed)3Dメッシュへ自動置換し、視覚レンダリングと力覚・トルクセンサーの双方に一致するよう摩擦・質量・接触ダイナミクスを反復キャリブレーションするほか、スケッチから全身バランスと多指投擲軌道を合成して高品質なBlender Cyclesレンダリングとして出力する能力を持つ26。
第三の「物理理解とエージェント型ハインドサイト・ラベリング」では、双腕ロボット「ALOHA 2」が136秒かけて折り紙のキツネを折るような精緻な作業映像を解析し、エピソード全体の指示(G1)、連続的な意味的サブタスク(G2)、3〜15秒単位の接触レベル原子プリミティブ(G3)という階層ラベルを自動生成する26。さらに品質管理(QC)として、ロボットが手間取ったり把持が不安定になったりした区間を自動検出し、模倣学習(Behavior Cloning)時に悪影響を与えないよう該当セグメントの重みを0.15倍〜0.25倍へと自動的に引き下げる(Reweighting)データ精製を実行する26。加えて、視覚推論のみによる物理パズル解決の領域では、双腕の「Franka FR3」とロベルバル天秤を用いた古典的な「12個のビリヤード球の中から重さの異なる1球を3回以内の計測で見つけ出すパズル」において、ステレオRGBカメラと固有受容感覚のみで球の3D座標を三角測量し、天秤の傾きを視覚的に測定して3回以内の試行で正確に異常球を特定・分離することに成功しており、第四の領域である「物理シミュレーションと実機ハードウェア上での反復的な自己改善研究」を大きく加速させている26。
5. サイバーセキュリティにおける双刃性とフロンティア・セーフティ・フレームワーク(FSF)
自律的脆弱性発見・修復能力と「Fairwind Program」の狙い
Gemini 4 Argonがリリース初日から一般公開されず、約2週間にわたり「Fairwind Program」を通じた段階的ロールアウト(Staged Rollout)を採った最大の理由は、同モデルが持つ極めて高度なサイバーセキュリティ能力にある1。GoogleがGemini 3.8 Flash Cyberバリアントで確立した技術をフロンティア層へ拡張したArgonは、「CodeMender」などのツールと連携し、膨大なコードベースやSIEMログ、ライブシステムから脆弱性を自律的に発見し、概念実証(PoC)コードを生成して検証した上で、修正パッチを作成・適用するまでの一連のプロセスを完遂できる1。
定量的にも、脆弱性の発見・修復能力を測る「CWE-bench v1」で68.0%(GPT-6 Astraと並ぶ首位タイ)を記録したほか、ソースコードを持たない状態で稼働中のWebシステムを検査するWiz社の社内ブラックボックス・ペネトレーションテストにおいて、攻撃対象領域(Attack surface)の発見、脆弱性特定、PoCエビデンス生成のすべてで3.8 Flash Cyberを凌駕した1。実際の防衛事例として、Wiz社の公共インフラ保護プロジェクト「Scan for Good」では、世界中の病院で稼働している医療用ソフトウェア群をArgonでスキャンし、従来のフロンティアモデルでは見落とされていた機密性の高い個人情報を露呈させる重大な脆弱性を発見・報告する成果を上げている2。またGoogle社内のランタイム権限フロー監査においても、過去2世代のフロンティアモデルが見逃していたアクセス制御に関する4つの致命的なセキュリティバグを特定した20。
TCL(脅威能力閾値)評価と4層のフロンティア・セーフガード
このような能力は防御側にとって強力な武器となる反面、悪意ある攻撃者に無制限に開放されればゼロデイ脆弱性の探索や攻撃の自動化に転用される深刻なリスク(Dual-use risk)を孕む1。Google DeepMindの「Frontier Safety Framework(FSF:フロンティア安全性フレームワーク)」に基づく評価において、Argonは高度なサイバーセキュリティ等の15の検証課題のうち14を通過(14/15)したため、Googleは同モデルについて「TCL(Threshold Capability Level:脅威能力閾値)への到達を排除できない(TCL cannot be ruled out)」と公式に判定した16。なお、より上位の危険水準であるCCL(Critical Capability Level)および「AI研究者の業務を同等のコストで完全自動化できる水準(ML R&D automation level 1)」については閾値未満(CCL not reached)と評価されている16。
TCL到達の可能性を受け、Googleは政府・重要インフラ・認定セキュリティパートナーに対してサイバー関連のガードレールを外したモデル(Unmitigated access)を「Fairwind Program」経由で先行提供し、防御側が先にシステムを強化するためのリードタイムを確保した上で、一般提供版にはリスクをTCL未満へ引き下げる4層のフロンティア・セーフガードを実装した2。第一の防御層である「悪用に対する防御」では、化学・生物・放射性物質・核(CBRN)兵器やサイバー攻撃への転用を防ぐため、モデル内部のアクティベーション監視(Internal activation monitoring)と、開発部門から独立した専門チームによる人間および自動化された大規模レッドチーミングが継続的に実施されている2。第二の防御層である「間接的プロンプトインジェクション(IPI)に対する防御」では、自律型エージェントが外部のWebページ、メール、またはサードパーティのコードベースを読み込む際に隠された悪意ある命令に乗っ取られるリスクに対処するため、敵対的学習と自動レッドチーミングを徹底した5。その結果、Gray Swan社のIPIベンチマークにおいて、攻撃者が手法を適応的に変えながら最大15回試行した際の攻撃成功率をわずか0.7%にまで封じ込め、業界1位の堅牢性を達成している2。
さらに第三の防御層として導入された「自動ミスアライメント・モニター(Automated Misalignment Monitor)」は、長時間動作するエージェントがタスクに行き詰まった際にテストを改ざんしたりシステム境界を越えて無断で処理を進めたりする「不正な近道(Unauthorized shortcuts / Workarounds)」を防止するため、エージェントのステップごとの思考プロセスと実行アクションをリアルタイムで読み取り、意図しない回避策を検出・ブロックして実行を停止させる深層防御機構である2。ここで特筆すべきは、強化学習の訓練中に「内部思考(Chain-of-Thought)そのものに直接ペナルティを与えない」設計を採ることで、モデルが監視を逃れるために本音の思考を隠蔽する現象を防ぎ、推論の透明性を維持したまま不正な近道の試行率を過去最低の2%へと劇的に低下させた点にある7。加えて、不可逆的な操作を行う前には必ず一時停止して人間の確認を求め、情報が見つからない場合やタスクを完遂できなかった場合には捏造せず正直にネガティブ報告を行うよう訓練されているほか、第四の防御層である「システムのハードニング」によって、高リスクなトレーニングや能力評価を開始する前段階で実行サンドボックス環境を厳格に隔離・密閉(Isolating and sealing sandbox environments)する制御ロードマップが適用されている2。
6. 提供形態・サブスクリプション体系とトークン経済学(TCO分析)
2026年10月13日一般提供(GA)後のアクセスチャネルと日本国内料金体系
2026年10月13日(米国時間)の一般提供開始により、Gemini 4 Argonは日本を含むグローバルで多様なチャネルから即座に利用可能となった6。なお、Googleは2026年10月9日より、個人の無料アカウントで「Gemini」アプリを利用する際の利用可能モデルを最軽量の「Flash-Lite」のみに制限する措置を講じており、Gemini 4 Argonを含む上位モデルの利用は有料サブスクリプションまたは従量課金APIへ明確に集約されている7。
また、個人・プロシューマー向けの「Google AI」プラン(旧Google One AIプラン)は、2026年5月の料金体系リニューアルによって「Google AI Plus」「Google AI Pro」、そして2階層化された「Google AI Ultra(5x枠 / 20x枠)」の構成へと再編されており(リニューアル前の月額36,400円・初回3カ月半額キャンペーンは終了)、各ユーザーの属性および契約ティアに応じたGemini 4 Argonへのアクセス経路と料金体系は以下の通り整理される7。
| 対象ユーザー・契約ティア | 利用可能なプラットフォーム・ツール | Argon利用可否・利用枠 | 日本国内料金・トークン課金単価(税込 / 米ドル) |
|---|---|---|---|
| 個人無料プラン / Google AI Plus | 「Gemini」アプリ(Web・モバイル) | 利用不可(無料版は10月9日よりFlash-Liteのみ)7 | 無料(0円 / 15GB)または Plus 月額 725円〜1,200円(200GB〜400GB、200 Flowクレジット/月)37 |
| Google AI Pro(個人・ビジネス標準) | 「Gemini」アプリ、Google検索「AIモード」7 | 利用可能(標準4x利用枠、5TBストレージ、1,000クレジット/月)7 | 月額 2,900円(Chromebook Plus購入者は2027年1月31日まで12カ月無料特典あり)37 |
| Google AI Ultra 5x(プロ・開発者) | 「Gemini」アプリ、検索AIモード、Google Antigravity、Google AI Studio、Android Studio7 | 利用可能(Pro比5倍枠、20TBストレージ、10,000クレジット/月)7 | 月額 14,500円(サイドプロジェクトでのAntigravity利用や中規模調査向け)36 |
| Google AI Ultra 20x(ヘビー開発者) | 「Gemini」アプリ、検索AIモード、Google Antigravity、Google AI Studio、Android Studio7 | 利用可能(Pro比20倍枠、30TBストレージ、25,000クレジット/月)7 | 月額 32,000円(Antigravityでの複数エージェント常時並列実行・大規模研究向け)36 |
| API開発者(導入価格期間) | Gemini API(gemini-4-argon)、Google AI Studio、Android Studio、Gen AI SDK、OpenRouter7 | 利用可能(1M統一コンテキスト、最大1M出力Long Decode対応)3 | 〜2026年11月30日まで:入力 $2.00 / 出力 $10.00(100万トークンあたり)、キャッシュ入力 95%オフ($0.10)37 |
| API開発者(標準価格期間) | Gemini API(gemini-4-argon)、Google AI Studio、Android Studio、Gen AI SDK7 | 利用可能(1M統一コンテキスト、最大1M出力Long Decode対応)3 | 2026年12月1日以降:入力 $4.00 / 出力 $20.00(100万トークンあたり)、キャッシュ入力 95%オフ($0.20)1335 |
| エンタープライズ企業 | Gemini for business(Web・デスクトップ・モバイル)、Gemini Platform API、Google Antigravity320 | 利用可能(Enterpriseサブスクリプションまたは従量課金)20 | 法人ライセンス契約、またはAPI従量課金(導入期 $2 / $10、12月以降 $4 / $20)3 |
| 学術研究者・サイバー防衛者 | Google Antigravity(研究者枠)/ Fairwind Program(防衛者向けガードレール解除版)3 | 利用可能(研究者は最上位枠、防衛者はサイバー制限なし)3 | 審査通過した研究者1万人にAntigravity最上位枠を6カ月間無償提供735 |
API価格戦略と「100万出力トークン」がもたらすトークン経済学のパラドックス
GoogleはGemini 4 Argonの市場投入にあたり、競合であるOpenAIの「GPT-6 Astra」に対して極めて攻撃的な価格設定(アンダカット戦略)を仕掛けている12。2026年11月30日までの期間限定で適用される導入価格(入力$2/出力$10 per 1M tokens)は、GPT-6 Astraのリスト価格のちょうど5分の1(0.2倍)(すなわちAstraは入力$10/出力$50相当)であり、2026年12月1日以降に適用される標準価格(入力$4/出力$20 per 1M tokens)に移行した後でもAstraの半分以下(0.4倍)の水準に抑えられている3。さらに、同一のコードベースや長大な法務・財務ドキュメントを繰り返し参照するエージェントワークフローにおいて決定的な意味を持つ「キャッシュ済み入力トークン(Cached input tokens)」に対しては95%オフ(導入期間中は100万トークンあたりわずか$0.10、標準価格期でも$0.20)という破格の割引を提供している2。
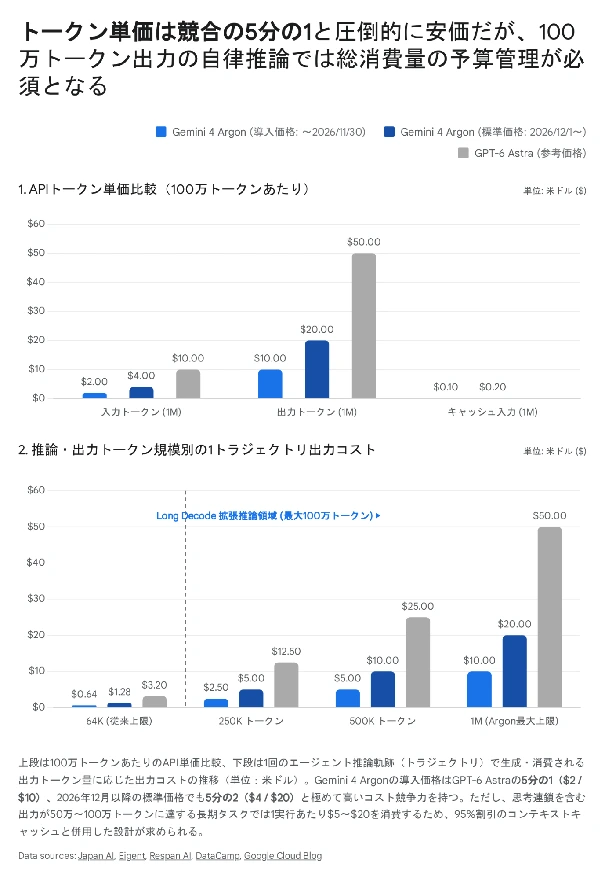
しかし、エンタープライズのAIアーキテクトがGemini 4 Argonを本番ワークフローへ組み込む際には、単価の安さだけに目を奪われてはならない構造的な注意点が存在する。それが「100万出力トークン上限と推論課金がもたらすトークン消費量の急増リスク」である4。
OpenAIと同様にGoogleも、モデルが内部で思考連鎖(Chain-of-Thought)を巡らせる推論トークンを「出力トークン」としてカウントし課金する仕組みを採用している15。従来のGemini 3系では出力上限が約6.4万トークンで物理的に頭打ちとなっていたため、仮に暴走気味のループが発生しても1回のAPIコールあたりの出力コストは最大でも約$0.64($10/1M換算)で自動的に止まっていた1。ところがArgonでは、複雑な問題を一度で解決するために最大100万トークンまでの連続生成(Long Decode)が許容されているため、自律エージェントが深い思考とコード修正・テストを数十ステップにわたって繰り返した場合、1つのトラジェクトリで数十万トークンの出力を一気に消費する可能性がある2。
実際に第三者機関Artificial Analysisのベンチマーク測定を見ても、導入価格ベースでの「タスクあたり加重平均コスト(Cost per Task)」において、Argonは同等の知能スコア(53点)を持つGPT-6 Astra(高推論モード)に対しては60%のコスト(40%安価)で済む一方、推論量を抑えた「GPT-6 Astra(lowモード:知能スコア46点、1タスク平均$0.82)」と「Gemini 4 Argon(highモード:知能スコア53点、1タスク平均$1.99)」を比較した場合には、深く長く思考するArgon(high)の方が1タスクあたりの実支払額が高くなる現象が確認されている17。また、入力プロンプトが27万2,000(272K)トークンを超える超長文検索(Retrieval)において、GPT-6 Astraには長文脈割増料金(Surcharge)が設定されているのに対し、Argonは95%オフのコンテキストキャッシュを活用することで長文入力コストを劇的に圧縮できる構造となっている3。したがって、ArgonのTCO(総所有コスト)を最適化するには、「長大な入力コンテキストは可能な限りキャッシュ化して95%割引($0.10〜$0.20/1M)を適用する」と同時に、「タスクの難易度に応じて同期デフォルト上限(65,536トークン)とLong Decode(最大1,048,576トークン)のmax_output_tokens設定を厳密に使い分ける」というトークン予算ガバナンスが不可欠となる3。
7. 結論と導入に向けたアーキテクチャ上の戦略的提言
以上の包括的調査から明らかなように、Google DeepMindの「Gemini 4 Argon」は、生成AIの主戦場を「チャットによる対話補助」から「数時間規模の専門実務とシステム改修を自律完遂するエージェント労働」へと引き上げる決定的なマイルストーンである1。企業のCTO、AIアーキテクト、および開発リーダーが同モデルを自社の技術スタックへ統合するにあたり、以下の3つの戦略的アプローチが推奨される。
第一に、ワークロード特性に応じたマルチモデル・ルーティングの徹底である。Argonは法務・財務・税務・人事などのドキュメント集約型ナレッジワーク(Harvey's Legal Agent BenchmarkやVals Index)、256K〜1Mトークンの超長文脈解析(GraphWalks)、長尺動画理解(LVBench)、および既存の大規模レガシーコードの長期モダナイゼーション(DeepSWE v1.1やC/C++からRustへの移行)において業界最高峰の性能と圧倒的なコストパフォーマンスを発揮する3。一方で、単発の超高難度アルゴリズム実装(FrontierSWE v2)や一部の科学・OSターミナル操作(Terminal-Bench Science 0.1、Terminal-bench 4.0)ではGPT-6 AstraやClaude Opus 5.5が依然として優位性を保っており、また日常的な軽量・低遅延タスクには既存の「Gemini 3.8 Flash」や今後登場が見込まれるGemini 4世代の軽量バリアント(Flash系)が適している4。すべてのタスクを単一モデルに依存するのではなく、Google Antigravityがサポートするモデル選択性(Model optionality)を活かし、長期・多段階の統合ワークフローにArgonを集中的に割り当てるハイブリッド構成が最も合理的である15。
第二に、2026年11月30日までの「導入価格期間」を活用したエージェンティック基盤の早期構築と検証である。API料金が標準価格(入力$4/出力$20)の半額である導入価格(入力$2/出力$10)で提供されている2026年11月末までの期間は、大規模コードベースのリファクタリングや法務・財務パイプラインのプロトタイピングを実行する絶好のウィンドウである1。この際、Google Antigravityの「カスタムエージェント(.agents/agents/へのMarkdown定義コミットによるチーム全体の標準化)」と「Skillsによるプログレッシブ・ディスクロージャー」を採用し、95%割引のコンテキストキャッシュと組み合わせることで、12月以降の標準価格移行後も競合比半分以下のランニングコストを維持できる強固なコスト構造を確立すべきである3。
第三に、自律型エージェントの権限設計とヒューマン・イン・ザ・ループ(HITL)のガバナンス整備である。Argonは間接的プロンプトインジェクション攻撃成功率を0.7%、不正な近道試行率を2%に抑える高度な安全機構を備え、不可逆な操作の前に確認を求めるよう訓練されているが、モデルカードにも明記されている通り、基盤モデル特有のハルシネーションや処理遅延・タイムアウトの可能性が完全にゼロになったわけではない3。Google自身がFuchsia Zircon kernelのRust移行や本番サポート対応において「エミュレーションテストと自動・手動の厳格な監査」や「人間の最終承認(Human approval)ゲート」を必須としている通り、ファイル削除や本番デプロイなどの高リスクコマンドは厳格に手動承認ゲート(Gated approvals)の背後に置き、バックグラウンドでの試行錯誤サイクルのみをArgonに自律委譲するアーキテクチャ設計が、安全性と生産性を極大化する鍵となる2。
引用文献 — References
- Gemini 4 Argonとは?特徴・料金・提供状況・性能をわかりやすく https://japan-ai.co.jp/media/10960/
- Gemini 4 Argon:フロンティア知能の新時代 - Google Blog https://blog.google/intl/ja-jp/company-news/technology/gemini4argon/
- Gemini 4 Argon available on Google Cloud https://cloud.google.com/blog/products/ai-machine-learning/gemini-4-argon-available-on-google-cloud
- Gemini 4 Argon:新機能、ベンチマーク、料金 - Eigent AI https://www.eigent.ai/ja/blog/gemini-4-argon
- Gemini 4 Argon の概要|npaka - note https://note.com/npaka/n/n0e3c4f8b40f8
- Gemini アプリで「Gemini 4 Argon」が利用可能に。Google AI Pro と AI Ultra が対象 https://helentech.jp/news-google-brings-gemini-4-argon-gemini-app-92548/
- 「Gemini 4 Argon」が一般提供開始 ~満を持して登場した最強の https://forest.watch.impress.co.jp/docs/news/2147842.html
- Gemini 4 Argon: Built to solve your hardest problems - Google Blog https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/
- https://ai.google.dev/gemini-api/docs/models/gemini-4-argon
- Only two directors, AI handles all practical work - note https://note.com/yoyoyoyo_anpan/n/n7874cf993c75?hl=en
- Google's Flagship AI Allegedly Leaked Early on Arena https://finance.biggo.com/news/66df2f89-c067-43d7-b888-94deb071f472
- Gemini 4 Argon Release Expected Today: Specs, Pricing & Leaks https://nokiapoweruser.com/gemini-4-argon-launch-specs-pricing-benchmarks/
- A new checkpoint of Google has been spotted! (Gemini 4 Carbon). https://www.reddit.com/r/GeminiAI/comments/1x292ly/a_new_checkpoint_of_google_has_been_spotted/
- Massive Leak: Google's New Gemini 4 Model Internal Beta Evaluation https://eu.36kr.com/en/p/4019400286621831
- Gemini 4 Argon vs. GPT-6 Astra: Which Model to Use - DataCamp https://www.datacamp.com/blog/gemini-4-argon-vs-gpt-6-astra
- Gemini 4 Argon - Model Card - Google DeepMind https://deepmind.google/models/model-cards/gemini-4-argon/
- Gemini 4 Argon benchmarks explained for people who don't read https://02ui.com/blog/gemini-4-argon-benchmarks-explained/
- Gemini 4 Argonとは?出力100万トークンの新モデルの性能・料金 https://digirise.ai/chaen-ai-lab/gemini-4-argon/
- Bringing our latest frontier model to Android Developers https://android-developers.googleblog.com/2026/10/bringing-gemini-4-argon-to-android-agentic-engineering-antigravity-cli.html
- Gemini 4 Argon in Google Antigravity https://antigravity.google/blog/gemini-4-argon-in-google-antigravity/
- Gemini 4 Argon vs GPT-6 Astra: Benchmarks, Pricing - AlphaCorp AI https://alphacorp.ai/blog/gemini-4-argon-vs-gpt-6-astra-benchmarks-pricing-and-which-is-better
- Gemini 4 Argon Benchmarks: Every Score, Its Source, and What It https://emergent.sh/learn/gemini-4-argon-benchmarks
- Google DeepMind Gemini 4 Argon正式リリース 100万トークン出力 https://digital-gorilla.co.jp/ai-lab/gemini-4-argon-release/
- Gemini 4 Argon vs GPT-6 Astra: benchmarks, price and context https://www.respan.ai/models/compare/gemini-4-argon-vs-gpt-6-astra
- Gemini 4 Argon (High) vs GPT-6 Astra (Low): Model Comparison https://artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gpt-6-astra-low
- Gemini 4 Argon for Robotics - Google for Developers Blog https://developers.googleblog.com/gemini-4-argon-for-robotics/
- Build with Google Antigravity, our new agentic development platform https://developers.googleblog.com/build-with-google-antigravity-our-new-agentic-development-platform/
- Google transform Antigravity Upgrade from an AI powered IDE to A https://discuss.ai.google.dev/t/google-transform-antigravity-upgrade-from-an-ai-powered-ide-to-a-software-a-seamless-coding-environment/145470
- 【Google参戦】Antigravity IDE|Gemini 3のエージェント主導開発 https://cielo-design.com/blog/google-antigravity-agent-ide-2026-08/
- サーフェスの選択: Antigravity 2.0、Antigravity CLI、Antigravity IDE https://cloud.google.com/blog/ja/topics/developers-practitioners/choosing-your-surface-antigravity-20-antigravity-cli-antigravity-ide-or-antigravity-sdk
- Getting Started with Google Antigravity - Codelabs https://codelabs.developers.google.com/getting-started-google-antigravity
- Antigravity 2.0 overview | Google Antigravity Docs https://antigravity.google/docs/overview/
- Download - Google Antigravity https://antigravity.google/download/
- Introducing custom agents | Google Antigravity Blog https://antigravity.google/blog/introducing-custom-agents/
- Google Gemini 4 Argon rolls out for developers, enterprises, Google AI subscribers in Antigravity, Gemini app and AI Mode in Search https://timesofindia.indiatimes.com/technology/tech-news/google-gemini-4-argon-rolls-out-for-developers-enterprises-google-ai-subscribers-in-antigravity-gemini-app-and-ai-mode-in-search/articleshow/134922523.cms
- 【2026年版】Google AIモードの料金比較|無料版と有料3種の違い https://ai-search.techsuite.co.jp/12262/
- Google AI Ultraとは?Pro版との違いや料金、限定機能を徹底解説 https://www.ai-souken.com/article/google-ai-ultra-guide
- 保存容量の追加、さらなる AI 機能、その他の機能 - Google One https://one.google.com/intl/ja_jp/about/
- Google AI Proとは?できること・料金プランの違い・活用例を解説 https://www.freee.co.jp/kb/kb-ai/google-ai-pro/
- Google AI Pro と AI Ultra の違いまとめ:日本で使える機能・料金と https://helentech.jp/google-ai-plans-comparison/
- Gemini 4 Argon (batch) - API Pricing & Providers | OpenRouter https://openrouter.ai/google/gemini-4-argon:batch
- Gemini 4 Argon - Google Cloud Console https://console.cloud.google.com/agent-platform/publishers/google/model-garden/gemini-4-argon
- Google Gemini 4 scores same as GPT 6 Astra on Artificial Analysis https://www.reddit.com/r/singularity/comments/1wug9tb/google_gemini_4_scores_same_as_gpt_6_astra_on/
